Überblick
Conversational Analytics im Unternehmen bedeutet, einfache Fragen in ausführbare Datenbankabfragen zu übersetzen, sodass Antworten direkt von strukturierten Datenplattformen stammen, ohne vorher Code schreiben oder ein Dashboard erstellen zu müssen.
Generative Modelle machten das Analysieren der Frage einfach. Die operative Hürde verschob sich an einen weniger offensichtlichen Ort: die Überprüfung der Antwort. Bei komplexen Unternehmensschemata scheitert ungeerdetes Text-zu-SQL-Verfahren durch falsche Joins, und veröffentlichte Benchmarks setzen die Bereitstellungsgenauigkeit auf einem Rohschema zwischen 50 % und 70 % und über 90 %, wenn Abfragen über eine verwaltete semantische Schicht kompiliert werden. Die Unterschiede zwischen Deployments derselben Technologie sind größer als die zwischen Technologien.
Konversationsanalyse definiert
Conversational Analytics ist eine Schnittstellenebene, keine Berechnungsengine. Die in der Datenbank ausgeführten Aggregationen, Filter und Joins bleiben Standard-SQL; was sich ändert, ist, wer sie ausführen kann und wie schnell eine Antwort eintrifft. Anstatt ein Ticket bei einem zentralen Datenteam einzureichen, äußert ein Nutzer seine Absicht in klarer Sprache und erhält ein verifiziertes Ergebnis. Es befindet sich in der breiteren Einführung von KI im gesamten Analysezyklus, an dem der Mensch angibt, was er wissen möchte.
Der Wert liegt nicht darin, Dashboards zu ersetzen, die bekannte Messgrößen verfolgen. Er liegt darin, die Ad-hoc-Mehrstufe-Fragen zu beantworten, für die Dashboards nie gedacht waren – ein plötzlicher Margenrückgang, eine Ausnahme für Lieferanten, ein einmaliger Kohortenvergleich – was in den meisten Organisationen der Ausgangspunkt der Analysten-Warteschlange ist.
Zwei Kernmodalitäten im Unternehmen
Konversationsbasierte KI umfasst sowohl Verbraucher- als auch technische Bereiche. In der Unternehmensanalyse teilt sich die Implementierung hauptsächlich in zwei Modalitäten mit unterschiedlichen Daten, unterschiedlichen Käufern und unterschiedlichen Ausfallmodi.
Abfrage strukturierter Geschäftsdaten (Text-zu-SQL)
Zugang in natürlicher Sprache zu strukturierten Daten, die in Plattformen, Seehäusern und Lagern gespeichert sind. Geschäftsleiter stellen operative Fragen – regionale Umsatzverschiebungen, Lagerumschlag, vierteljährliche Abweichungen – und das System kompiliert diese zu Datenbankabfragen. Diese Fragen hat Business Intelligence schon immer beantwortet. Dieser Leitfaden behandelt diese Modalität.
Analyse unstrukturierter Kundeninteraktionen
Analyse von Konversationsdaten selbst – Kontaktzentrum-Transkripten, Chatprotokolle, E-Mails – um Stimmung, Absicht und operative Reibung zu extrahieren. Sie basiert auf Sprach-zu-Text, Sprachverständnis und Vektortext-Mining statt auf Abfragegenerierung. Die Analyse von Kundengesprächen im großen Maßstab ist ein bedeutendes Thema für sich und wird getrennt behandelt. Die Bewertung der beiden erfordert völlig unterschiedliche architektonische Kriterien.
Wie Conversational Analytics funktioniert
Die Umwandlung einer menschlichen Frage in eine mathematisch fundierte Datenbankanfrage erfordert vier Schritte. Der Großteil des Unterschieds zwischen den Plattformen liegt im zweiten Schritt.
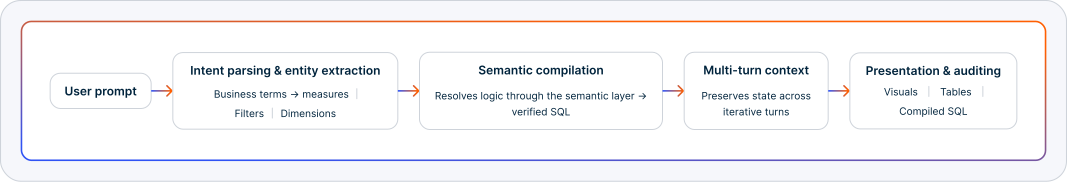
Intent-Parsing und Entitätsextraktion
Foundation-Modelle analysieren den Prompt und isolieren Messgrößen wie Nettoumsatz, Dimensionen wie Verkaufsregion und Zeitbeschränkungen wie ein Quartal im Vergleich zum gleichen Quartal des Vorjahres. Sprachvariation wird gut gehandhabt – dies ist der Schritt, in dem aktuelle Modelle gut sind.
Abfragegenerierung und semantische Kompilierung
Die extrahierte Intention wird in ausführbaren Code kompiliert. Grundlegende Systeme erzeugen SQL direkt anhand der rohen Spaltennamen und schließen ab, wie Tabellen miteinander verbunden sind. Fortschrittliche Architektur wird durch eine verwaltete semantische Schicht kompiliert, auf der Metrikdefinitionen, Join-Pfade und Geschäftsregeln im Voraus zertifiziert werden. Der Unterschied klingt technisch und ist der wichtigste Einzelfaktor dafür, ob die Antwort korrekt ist – die Mechanik der Datenabfrage in natürlicher Sprache hängt von diesem Schritt ab, um halluzinierte Logik zu verhindern.
Mehrschichtige Kontextspeicherung
Die reale Analyse ist iterativ: Die zweite Frage verfeinert die erste, die dritte schränkt wieder ein. Kontextspeicherung erhält vorherige Filter, Zustandsvariablen und Aggregationsniveaus, sodass eine Nachverfolgung nicht alles wiederholt erfordert – ohne sie kehren Nutzer zur Analysten-Warteschlange zurück, die sie umgehen wollten.
Ergebnispräsentation und Abfrageprüfung
Rückgegebene Nutzlasten werden zu Diagrammen, Zusammenfassungstabellen oder Text. Entscheidend ist, dass Unternehmensplattformen das kompilierte SQL zusammen mit der Visualisierung anzeigen, sodass ein Analyst die exakte Logik prüfen kann, die die Ausgabe erzeugt hat. Ergebnisse in Visualisierungen umzuwandeln ist gut verstanden; die Darstellung der Arbeit entscheidet, ob Analysten ihr vertrauen.
Warum die Genauigkeit so stark variiert
Die betriebliche Zuverlässigkeit hängt von den strukturellen Metadaten ab, die dem System zur Verfügung stehen, und nicht von der rohen Leistungsfähigkeit des dahinterstehenden Modells.
|
Bewertungsumfeld |
Basis/ungeerdet |
Gesteuert/modelliert |
Quelle und Testdetails |
|
Unmodellierter Basisdatensatz |
64,5 % Gesamttext-zu-SQL |
72,7 % semantische Schicht |
dbt Labs ACME Insurance Benchmark, April 2026 – 11 Fragen, 20 Durchläufe, 15 Tabellen |
|
Vollständig modellierte Daten |
90,0 % (Claude Sonnet 4,6)/84,1 % (GPT-5,3 Codex) |
98,2 % (Claude Sonnet 4,6)/100 % (GPT-5,3 Codex) |
dbt Labs ACME Insurance Benchmark, April 2026. Die Modellierungsqualität verbessert sowohl direkte SQL als auch die semantische Ausführung. |
|
Komplexe Unternehmensschemata |
— |
76.13% |
BIRD-Benchmark, einzeln trainierte Modellspur. Vom Anbieter gemeldet. |
Wie Datenmodellierung und semantische Schichten Ergebnisse beeinflussen
Modelle wissen nicht von Natur aus, wie eine Organisation ihre Begriffe definiert. Sie können keinen benutzerdefinierten Offset des Finanzkalenders, einen Netto-gegen-Bruttoumsatz-Ausschluss oder einen korrekten Join-Pfad, den niemand geschrieben hat, ableiten. Eine semantische Schicht ist das Übersetzungsgewebe zwischen Frage und Schema: Sie definiert jede Metrik einmal und speichert zertifizierte Berechnungslogik, Tabellenbeziehungen und die Zugriffspolitik auf Zeilenebene. Das Modell bildet die Absicht auf diese Definitionen zu, anstatt auf Datenbanklogik zu raten. Die Verankerung im Geschäftskontext sorgt dafür, dass das Stellen derselben Frage in jeder Geschäftseinheit dieselbe Zahl zurückgibt.
Die Implikation für Käufer ist nützlich. Wenn die semantische Grundlage nicht geleistet wurde, wird kein Produkt in dieser Kategorie so abschneiden wie seine Demonstration – weil die Demonstration mit modellierten Daten ablief.
Versagensarten zur Bewertung
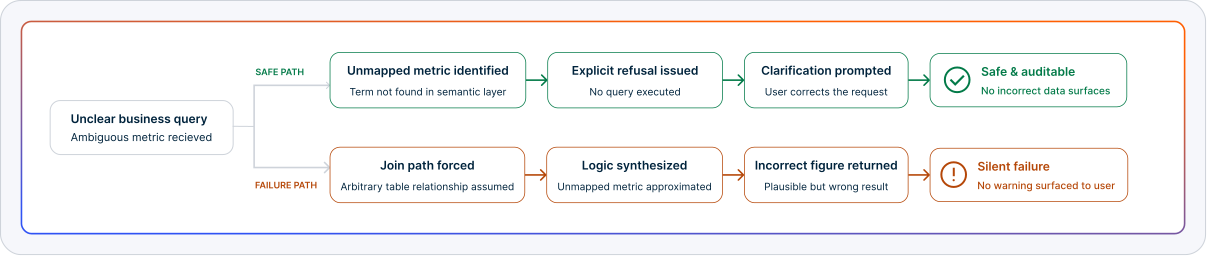
Ungeerdete Engines versagen lautlos. Sie erzwingen einen plausiblen Join-Pfad, nehmen einen fehlenden Filterwert an und geben eine zuversichtliche, korrekt formatierte Zahl zurück, die falsch ist. Niemand weiß, wie man sie überprüft. In einem Board Pack wird diese Zahl zu einer Entscheidung. Praktiker bringen das immer wieder zur Sprache, und deshalb sind erfahrene Analyseteams bei dieser Kategorie vorsichtiger als das Marketing vermuten lässt: Die Hürde für das Stellen einer Frage ist gesunken, die Hürde für die Interpretation einer Antwort ist gesunken.
Anwendungsfälle für reale Unternehmen
Self-Service Executive und Geschäftsberichterstattung
Führungskräfte ziehen Periodenwachstum oder regionale Margenänderungen vor, ohne sich in eine Analystenwarteschlange einzureihen.
Implementierungsanforderung: Zentralisierte Metrikdefinitionen, sodass zwei Führungskräfte, die dieselbe Frage stellen, die gleiche Anzahl erhalten.
Finanzielle Varianzzerlegung
Finanzen hinterfragen die Varianz von Posten während des Abschlusses und identifizieren, ob ein Überlauf durch Volumen, Preis oder Währung verursacht wurde.
Implementierungsanforderung: Zertifizierte Kontohierarchien und Periodenschluss-Flags, die in der Metadatenschicht gehalten werden.
Betrieb und Überwachung von Ausnahmen in der Lieferkette
Logistics verfolgt Engpässe über Multi-Region-Lieferantennetzwerke hinweg und identifiziert betroffene Lagerbestände sofort in dem Moment, in dem eine Ausnahme ausgelöst wird.
Implementierungsanforderung: Abfrageverarbeitung mit hoher Nebenläufigkeit und aktuelle Betriebsdaten.
Kundenkohorte und Marketinganalyse
Marketing, Größen, Kohorten und Lifetime Value über individuelle Attribute hinweg messen, ohne dedizierte technische Unterstützung.
Implementierungsanforderung: Zuverlässige Identitätslösung über CRM- und Abrechnungstabellen hinweg.
Vorteile und Abhängigkeiten der Governance
Die Entscheidungsverzögerung sinkt, weil die mehrtägige Schleife durch eine Berichtswarteschlange verschwindet. Data Engineers werden von der Abrufarbeit entlassen und auf Modellierung und Plattformsteuerung überlassen. Mehr Entscheidungen werden auf Basis von Beweisen getroffen statt auf Instinkt, was das Ergebnis ist, das Decision Intelligence seit Jahren verfolgt.
Jeder Vorteil birgt dieselbe Abhängigkeit. Natürlichsprachige Schnittstellen machen das Fragen einfach; zentralisiertes semantisches Management macht die Antworten vertrauenswürdig. Der Wert entsteht nur, wenn die geschäftliche Bedeutung in der Datenschicht erfasst wurde, anstatt im Kopf der früheren Beantworter der Fragen zu sein.
Was in Unternehmens-Conversational-Analytics-Software bewertet werden sollte
Demonstrationen in dieser Kategorie sind ungewöhnlich überzeugend, da sie auf Daten basieren, die für die Demonstration modelliert wurden. Sieben Fragen unterscheiden das, was ein Produkt zeigt, von dem, was es auf einem Unternehmensgelände leisten wird.
|
Anforderung |
Stresstest, um in der Demo zu fragen |
Warum sie das Ergebnis bestimmt |
|
Zentralisierte Kennzahlenverwaltung |
Wo befinden sich metrische Definitionen – in Prompt-Vorlagen oder einer semantischen Schicht? |
Prompt-Definitionen verursachen Metrik-Drift zwischen Geschäftseinheiten. Logik muss zentralisiert werden. |
|
Deterministische Fehlerbehandlung |
Was passiert, wenn eine Abfrage eine nicht abgebildete Metrik nennt? |
Das System muss ablehnen oder klären. Eine stille Halluzination in einem Finanzbericht ist ein unüberwachtes Risiko. |
|
SQL-Prüfbarkeit |
Kann ein Analyst die generierte SQL ansehen, debuggen und kopieren? |
Analysten vertrauen den Ergebnissen, die sie nicht überprüfen können, nicht, und die regulierte Berichterstattung kann sie nicht nutzen. |
|
Datenbankebene Berechtigungen |
Wird die Abfrage unter der Datenbankrolle des Nutzers oder einem Service-Konto ausgeführt? |
Wenn die Schnittstelle das Zugriffsmodell umgeht, hat sie ein Governance-Problem geschaffen und kein Access-Problem gelöst. |
|
Föderierte Hinrichtung |
Kann die Engine über Hybrid- und Multi-Cloud-Anlagen hinweg Abfragen leisten, ohne Daten zu verschieben? |
Die meisten Plattformen in dieser Kategorie fragen ein Lager ab. Alles andere benötigt eine Föderation oder Replikation. |
|
Zugriff auf unstrukturierte Daten |
Kann es relationale Tabellen mit vektoreingebetteten Transkripten und Logs verbinden? |
Ein wachsender Anteil der Unternehmensfragen betrifft Inhalte, die nie in eine Tabelle gelangen. |
|
Vereinheitlichte Steuerebene |
Werden Modelle, semantische Definitionen und Telemetrie gemeinsam verwaltet? |
Plattformen, die all das gemeinsam verwalten – wie Teradata AI Studio – beantworten mehrere dieser Fragen an einem einzigen Ort. |
Wohin das führt: Agentische Analysen und offene Protokolle
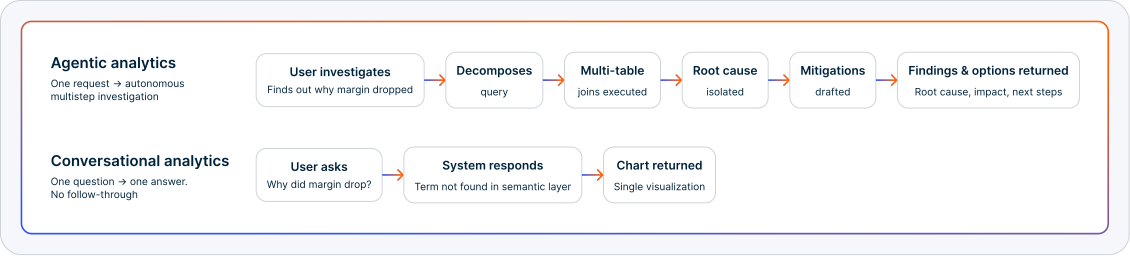
Conversational Analytics beantwortet einen Prompt. Agentic AI übernimmt eine Aufgabe – plant eine Sequenz, führt mehrere Abfragen aus, bewertet Ergebnisse und entscheidet, was als Nächstes zu tun ist. Auf Analytics angewandt bedeutet das ein System, das untersucht statt reagiert. KI-Agenten in Business Intelligence sind die kurzfristige Form davon.
Autonomie verändert, was Integration bieten muss. Offene Schnittstellen wie das Model Context Protocol standardisieren die Kommunikation zwischen Agenten und externen Werkzeugen; Unternehmensimplementierungen wie Teradata Enterprise MCP fügen Authentifizierung, Autorisierung und rollenbasierte Zugriffskontrolle darüber hinzu. Orchestrierungsschichten wie Teradata Enterprise AgentStack liefern die Telemetrie- und Sicherheitsgrenzen, die die Bereitstellung gegen Produktionsdaten verteidigbar machen, und Multi-Agenten-Systeme schärfen das Ganze weiter – Attribution wird wirklich schwierig, sobald mehrere Agenten zu einem Ergebnis beitragen.
Fazit
Conversational Analytics verändert, wie Unternehmensteams an ihre Daten gelangen, aber der Erfolg hängt viel mehr von semantischer Grundlage ab als vom Interface-Design. Ob es in jeder Organisation funktioniert, ist eine Frage der Daten dieser Organisation: Ob Metriken einmal definiert sind, ob Berechtigungen überall dort gelten, wo die Daten erreicht werden, und ob das System dies sagt, wenn es es nicht weiß. Plattformen, die natürliche Sprachanfragen in zertifizierter Geschäftslogik verankern – wie Tera auf Teradata Cloud – kommen zu derselben Schlussfolgerung wie die Benchmarks: Die Schnittstelle ist der einfache Teil, und die darunterliegende Bedeutung nicht.
Um Controlled Conversational Analytics anhand Ihrer eigenen Metrik-Definitionen und dem Zugriffsmodell anhand eines Demonstrationsdatensatzes zu bewerten, sprechen Sie mit uns.
Häufig gestellte Fragen
Was ist der Unterschied zwischen konversationeller Analyse und konversationeller KI?
Was ist der Unterschied zwischen konversationeller Analyse und konversationeller KI?
Konversationsbasierte KI ist das breite Feld von Systemen, die einen Dialog führen – virtuelle Assistenten, Kontaktcenter-Bots. Konversationsanalyse ist die engere Anwendung dieser Fähigkeit auf Daten: Die Fragen betreffen Metriken, Trends und Segmente, und die Antwort wird durch Abfrage einer Datenquelle erzeugt, anstatt eine geskriptete Antwort abzurufen.
Ersetzt Conversational Analytics Dashboards?
Ersetzt Conversational Analytics Dashboards?
Nein. Dashboards bleiben die effizienteste Methode, um eine feste Menge von Messungen zu überwachen, die viele Menschen beobachten. Konversationsanalysen ergänzen sie, indem sie die Ad-hoc-Fragen mit mehreren Schritten bearbeiten, für die ein Dashboard nie konzipiert wurde.
Müssen die Nutzer die Daten trotzdem verstehen?
Müssen die Nutzer die Daten trotzdem verstehen?
Ja, und das ist die häufigste Fehlinterpretation der Kategorie. Diese Tools senken die Hürde, eine Frage zu stellen, ohne die Hürde für die Interpretation der Antwort zu senken. Jemand muss trotzdem wissen, ob die Zahl das bedeutet, was sie zu bedeuten scheint, weshalb der Geschäftskontext in der Datenschicht wichtiger ist als die konversationelle Feinschliff der Benutzeroberfläche.
Worin unterscheidet sich Conversational Analytics von agentic analytics?
Worin unterscheidet sich Conversational Analytics von agentic analytics?
Conversational Analytics beantwortet eine Frage. Agentic Analytics erfüllt eine Aufgabe: Es plant eine Abfolge von Schritten, führt mehrere Abfragen aus, bewertet, was zurückkommt, und entscheidet, was als Nächstes zu tun ist. Der Unterschied liegt zwischen einem System, das antwortet, und einem, das handelt, und es verändert, welche Governance die Deployment benötigt.