Überblick
Wichtige Erkenntnisse
- Elastisches Rechnen skaliert Rechenleistung, Speicher und Speicher dynamisch, je nach der Nachfrage schwankend, wodurch manuelle administrative Eingriffe entfallen.
- Das Deprovisionieren von ungenutzten Ressourcen bei sinkender Nachfrage ist genauso wichtig wie eine Hochskalierung; die Effizienz des Herunterskalierens bestimmt direkt die Einsparungen in der Cloud-Kosten.
- "Elastisches Rechnen" und "Cloud-Elastizität" beziehen sich auf dieselbe operative Fähigkeit und werden austauschbar innerhalb der Unternehmens-Cloud-Architektur verwendet.
- Elasticity liefert maximale Rendite für bursty-, saisonale und ad-hoc-KI-/Analyse-Workloads. Kontinuierliche, stationäre Reporting-Workloads profitieren deutlich weniger.
- Ohne harte Skalierungsgrenzen, Echtzeit-Telemetrie und Kostenzuweisung auf Abteilungsebene kann dynamische automatische Skalierung unkontrollierte Betriebskosten verursachen.
Elastisches Rechnen, definiert
Die traditionelle Unternehmenskapazitätsplanung basiert auf statischer Prognose: Infrastrukturteams schätzen den Spitzenbedarf an Ressourcen, kaufen physische Hardware oder reservierte Instanzen, um diesen Peak abzudecken, und tragen die finanziellen Kosten der Stillstandskapazität während Off-Peak-Fenstern.
Elastisches Rechnen ersetzt statische Prognosen durch eine kontinuierliche operative Rückkopplungsschleife. Die Cloud-Plattform überwacht die aktive Workload-Telemetrie und bereitet in Echtzeit dynamisch Ressourcen bereit oder de-provisioniert.
Zwei definierende Eigenschaften unterscheiden echtes elastisches Rechnen von statischer reservierter Infrastruktur.
- Automatisierung: Ressourcenanpassungen erfolgen programmatisch basierend auf Echtzeit-Auslastungstriggern und erfordern keinerlei menschliches Eingreifen.
- Bidirektionalität: Die Kapazität wird automatisch reduziert, wenn die Nebenwahl abfällt, was die variablen Cloud-Infrastrukturkosten direkt begrenzt.
In Cloud-Data-Warehousing, Data Lakehouses und Unternehmensanalysen wird diese architektonische Eigenschaft auch als Cloud-Elastizität bezeichnet. Beide Begriffe beschreiben den zugrunde liegenden Mechanismus, das Rechenangebot an die Echtzeit-Verarbeitungsnachfrage anzupassen.
Wie elastisches Rechnen funktioniert
Was tatsächlich skaliert
In Unternehmensdatenplattformen und KI-Architekturen erstreckt sich die Elastizität über drei unterschiedliche Infrastrukturebenen – jede passt sich mit unterschiedlichen Geschwindigkeiten an.
- Rechenleistung: Rechenkapazität, bereitgestellt über isolierte virtuelle Knoten oder Ausführungscluster. Compute ist die am schnellsten anzupassende Schicht und dient als primärer Schalter zur Verwaltung von Workload-Spitzen.
- Speicher: Skaliert zusammen mit Recheninstanzen, ist der System-RAM häufig der operative Engpass für komplexe analytische Joins, hochzeitige Vektorsuche und verteilte maschinelle Lernalgorithmen.
- Speicher: Moderne Cloud-Datenarchitekturen entkoppeln Rechenleistung vom Speicher und nutzen dabei Shared-Objekt-Store-Tiers. Diese Trennung ermöglicht es Rechenressourcen, sich dynamisch auszudehnen und zu kontraktieren, ohne dass zugrundeliegende Datensätze innerhalb der Teradata-Datenbank neu partitioniert oder physisch verschoben werden.
Was löst ein Skalierungsereignis aus?
Skalierungsaktionen werden von Systemüberwachungs-Engines gesteuert, die operative Kennzahlen anhand vordefinierter Richtlinienschwellenwerte verfolgen. Gängige operative Trigger sind:
- Anhaltende CPU- oder Knotenauslastung, die definierte Grenzen überschreitet (z. B. 85 % Auslastung innerhalb eines dreiminütigen Zeitfensters).
- Wachsende Tiefen der Abfrage-Warteschlangen oder Nebenläufigkeitsgrenzen bei unerwarteten Verkehrsspitzen.
- Spitzen in Streaming-Daten-Aufnahmepipelines oder Echtzeit-API-Anfragen.
- Hochzeitgleichzeitige Modellbewertung, Feature Engineering oder agentische Workflows werden über die In-Datenbank-Analysefunktionen der Teradata Database initiiert.
Unternehmensplattformen ermöglichen es Systemadministratoren, explizite obere und untere Grenzwerte festzulegen, sodass die automatische Skalierung strikt innerhalb von vorab genehmigten Parametern erfolgt.
Das Herunterskalieren ist der schwierigere Teil
Die Kapazitätserweiterung während eines Nachfrageanstiegs ist einfach; Kontraktion ist der Punkt, an dem der wirtschaftliche ROI der Cloud gewonnen oder verloren wird. Wenn Rechenknoten zu aggressiv deprovisionieren, stoßen nachfolgende Abfragebursts auf Kaltstart-Latenz. Wenn Knoten lange nach Abschluss der Ausführung bereitgestellt bleiben, verschwinden die erwarteten Cloud-Kosteneinsparungen schnell.
Da 84 % der Führungskräfte Cloud-Ausgabenmanagement als primäres operatives Hindernis angeben, sind effektive Node-Teardown-Richtlinien entscheidend. Für einen ausführlichen operativen Überblick über Instanzbereitstellung, Node-Teardown und Workload-Isolation lesen Sie die Dokumentation About Teradata Elastic Compute .
Ein Beispiel für elastisches Rechnen in der Praxis
Stellen Sie sich ein globales Einzelhandelsunternehmen vor, das Enterprise-Analysen für tägliche Transaktionsvolumina durchführt. Während einer jährlichen Werbeveranstaltung steigt der gleichzeitige Nutzertraffic um das Zehnfache, da Lieferketten-, Marketing-, Lagerbestands- und Kundenerlebnisteams Ad-hoc-Analyseanfragen gleichzeitig ausführen. Gleichzeitig werden automatisierte Empfehlungsmodelle kontinuierlich ausgeführt und nicht in Nebenzeiten nächtlicher Chargen.
Ohne elastisches Rechnen steht das Unternehmen vor zwei teuren Entscheidungen.
- Überprovision: Die dauerhafte Dimensionierung der Infrastruktur für das Spitzen-Promotionsvolumen lässt bis zu 70 % der Rechenkapazität während der regulären Geschäftswochen ungenutzt.
- Unterversorgung: Die Dimensionierung der Infrastruktur für die mittlere Tagesnachfrage führt zu Abfrage-Warteschlangen-Timeouts, verschlechterter Portalleistung und potenzieller Umsatzverluste während der Spitzenaktionszeiten.
Mit einer elastischen Cloud-Architektur jedoch skalieren unabhängige Rechencluster automatisch nach außen, wenn sich die Abfrage-Nebenzeitigkeit aufbaut, halten den Durchsatz während der Hauptverkehrszeiten aufrecht und beenden automatisch, wenn sich der Verkehr normalisiert. Das Unternehmen zahlt für erhöhte Rechenkapazitäten ausschließlich während der aktiven Betriebszeiten.
Elastizität und Skalierbarkeit sind nicht dasselbe
Obwohl oft synonym verwendet, adressieren Skalierbarkeit und Elastizität grundlegend unterschiedliche technische Ziele:
| Merkmalsdimension | Skalierbarkeit | Elastizität |
|---|---|---|
| Hauptfokus | Die strukturelle maximale Kapazität, um das kumulative Arbeitslastwachstum im Laufe der Zeit zu bewältigen. | Die Echtzeitgeschwindigkeit und Automatisierung der Ressourcenausdehnung und -kontraktion. |
| Anpassungsmodell | Kapazitätserweiterung (vertikal über größere Hardware oder horizontal über zusätzliche Knoten). | Dynamische, richtlinienbasierte automatische Bereitstellung und automatische De-Provisioning. |
| Betriebsziel | Unterstützung langfristiger, vorhersehbarer Geschäfts- und Datenvolumenerweiterung. | Kurzfristige, schwankende Nachfragespitzen werden angepasst, ohne für ungenutzte Hardware zu viel zu bezahlen. |
| Bereitstellungsgeschwindigkeit | Minuten bis Tage (oft mit manueller administrativer Bereitstellung oder Beschaffung). | Sekunden bis Minuten (automatisch gesteuert durch Systemtelemetrie-Trigger). |
Ein System kann hoch skalierbar sein, ohne elastisch zu sein. On-Premises Data Warehouses skalieren oft auf Petabytes Speicher, aber die Erhöhung der Rechenkapazität erfordert Hardwareanschaffung und dauerhafte Installation.
Für eine umfassende vergleichende Aufschlüsselung lesen Sie unseren ausführlichen Leitfaden zu Cloud-Elastizität vs. Cloud-Skalierbarkeit.
Wo sich elastisches Rechnen auszahlt
- Bursty und unvorhersehbare Arbeitslasten: Wenn Anwendungen erhebliche Unterschiede zwischen Baseline- und Spitzenressourcenbedarf aufweisen, können Organisationen sofortige finanzielle Erträge durch die Implementierung der On-Demand-Compute-Allokation erzielen.
- Data Science, KI und Modelltraining: Das Training von Machine-Learning-Modellen, die Durchführung von Retrieval-Augmented Generation (RAG)-Vektorsuchen und die Durchführung von Ad-hoc-Data-Science-Exploration erfordern umfangreiche Rechenleistungen für begrenzte Zeiträume. Elastische Rechencluster ermöglichen es Teams, dedizierte Knoten für die Ausführung zu starten und diese sofort nach Abschluss herunterzufahren.
- Saisonale und ereignisgesteuerte Verarbeitung: Monatliche Finanzschließungen, vierteljährliche Regulierungsmeldungen und Werbeverkäufe im Einzelhandel führen zu vorhersehbaren Spitzen, die am besten durch dynamische Allokation statt durch eine dauerhafte Hardware-Erweiterung abgedeckt werden. Diese Muster sind bereits in den Zahlen des letzten Jahres dokumentiert, was sie zu den leichtesten zu rechtfertigenden Elastizitätsfällen macht.
Unternehmensüberlegungen
Kostenvorhersagbarkeit und Leitplanken
Neuere Unternehmensforschungen zeigen, dass 29 % der Ausgaben für öffentliche Cloud-Infrastruktur durch Verschwendung verloren gehen – hauptsächlich verursacht durch unmanaged Compute Scaling und leere Entwicklerumgebungen. Um die Budgetvorhersehbarkeit aufrechtzuerhalten, müssen FinOps-Teams klare Infrastruktur-Schutzmechanismen durchsetzen: Verbrauchsbasierte Cloud-Preismodelle machen diese Ausgaben sichtbar, und eine Kostenschätzung auf Workload-Ebene zeigt, was ein bestimmter Mix tatsächlich kostet, bevor er bereitgestellt wird.
Betrachten Sie diese Infrastruktur-Leitplanken.
- Definierte Skalierungsbereiche: Strenge obere und untere Grenzen für die automatische Skalierung von Instanzen, um unkontrollierten Rechenaufwand während Abfrageanomalien zu verhindern.
- Echtzeit-Telemetrie und Benachrichtigungen: Protokollierung von Skalierungsereignissen, um Plattformadministratoren sofortige Transparenz darüber zu geben, warum Ressourcenerweiterungen ausgelöst werden.
- Kostenattribution und Showback: Tagging dynamischer Recheninstanzen nach Abteilung, Projekt oder Geschäftseinheit, um finanzielle Rechenschaftspflicht durchzusetzen.
Verwaltung und Zugriffskontrolle
Unkontrolliertes automatisches Skalieren schafft operative und sicherheitspolitische Risiken. Enterprise-Cloud-Bereitstellungen müssen rollenbasierte Zugriffskontrolle (RBAC) durchsetzen, sicherstellen, dass Datenverschlüsselungsrichtlinien automatisch über dynamische Rechencluster ausgeweitet werden, und alle Skalierungsereignisse für Compliance-Prüfungen protokollieren.
Wenn Elastizität die falsche Antwort ist
Elastisches Rechnen ist keine universelle Lösung für jedes Enterprise-Workload-Profil und ergibt in diesen Szenarien möglicherweise keinen Sinn.
- Vorhersehbare Baseline-Verarbeitung: Kern-Abfragen des Unternehmens-Data-Warehouses , die mit konstanter, hoher Auslastung laufen, arbeiten mit dedizierten, reservierten Rechenkapazitäten deutlich kosteneffizienter.
- SLAs mit ultraniedriger Latenz : Workloads, die die kurze Initialisierungslatenz zum Starten neuer Rechenknoten nicht tolerieren können, benötigen eine vorab zugewiesene, immer aktive Infrastruktur.
- Speicher- oder I/O-gebundene Engpässe: Das Hinzufügen von Rechenclustern zu einer Anwendung, die durch Netzwerkdurchsatz oder Speicherdisk-I/O eingeschränkt ist, verbessert die Ausführungsgeschwindigkeit nicht.
Um strukturelle Abwägungen zwischen dedizierter Baseline-Infrastruktur und dynamischer Berechnung zu bewerten, entdecken Sie unsere Analyse von The Always-On Reality.
Elastisches Rechnen auf Teradata
Moderne Unternehmensdatenarchitekturen müssen Steady-State-Geschäftsberichterstattung zusammen mit unvorhersehbaren, hochzeitigen Analysen unterstützen. Teradata Cloud vereint beide Rechenmodelle unter einem einzigen Workload-Management-Framework:
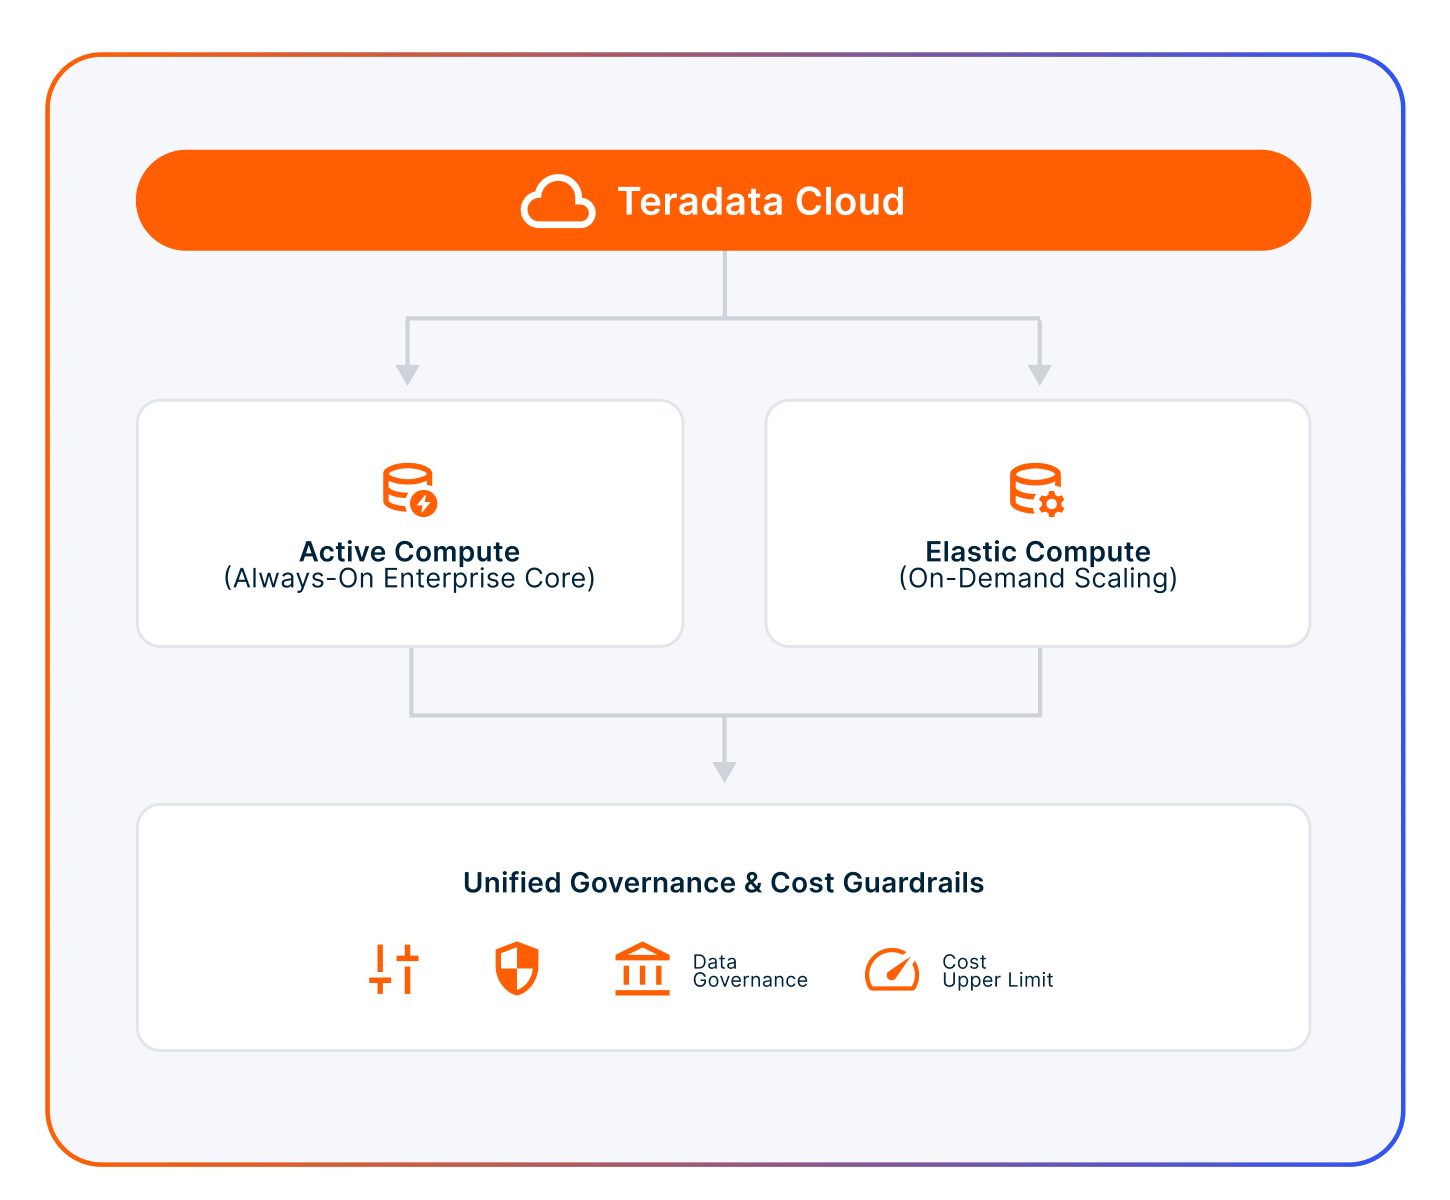
- Teradata Active Compute: Liefert immer-on, dedizierte Compute-Knoten für vorhersehbare Unternehmens-Data-Warehousing, operative Berichte und Kern-Dashboards zu stabilen Raten.
- Teradata-elastische Rechenleistung: Bietet dynamische, on-demand-Skalierung von Rechenclustern für explorative Data Science, Ad-hoc-Abteilungsanalysen und KI-Modellausführung. Diese isolierten Cluster skalieren unabhängig von der zugrundeliegenden Objektspeicherung (einschließlich offener Tabellenformate wie Iceberg und Delta) und werden automatisch deprovisioniert, wenn die Arbeitslasten abgeschlossen sind.
Durch die Koordination von aktivem und elastischem Rechnen unter einheitlichem Workload-Management eliminieren Unternehmensorganisationen Ressourcenkonkurrenz, halten strenge Kostenobergrenzen ein und ermöglichen kontinuierliche Analysen ohne Überprovisionierung der Infrastruktur.
Dasselbe Workload-Management gilt überall dort, wo die Plattform über AWS, Microsoft Azure und Google Cloud bereitgestellt wird.
Fazit
Elastic Computing hat neu definiert, wie moderne Unternehmen Cloud-Analysen gestalten und bezahlen. Durch die dynamische Zuordnung von Rechenleistung an Verarbeitungsbedarf in Echtzeit entfallen Organisationen die Notwendigkeit, teure Infrastruktur für kurze Nutzungsspitzen zu überprovisionieren. Um die wahren finanziellen Vorteile der Cloud-Elastizität zu nutzen, ist jedoch eine bewusste operative Governance erforderlich. Ohne strikte Skalierungsobergrenzen, Echtzeit-Telemetrie und klare Kostenzuweisung können automatische Skalierungsfunktionen Cloud-Ausgaben schnell verschärfen.
Die effektivsten Unternehmensdatenstrategien kombinieren elastische Skalierung mit dediziertem Baseline-Computing, sodass Bursty-Analysen und KI-Workloads bedarfsgerecht skalieren können, während Steady-State-Reporting vorhersehbar und mit maximaler Kosteneffizienz läuft.
Bereit, Ihre Cloud-Datenarchitektur zu optimieren?
Aufbauen Sie eine skalierbare, kostenkontrollierte Datenbasis
Entdecken Sie, wie Sie vorhersehbare Enterprise-Workloads mit dynamischem, bedarfsorientiertem Skalieren auf der Teradata Autonomous Knowledge Plattform in Einklang bringen können. Entdecken Sie Teradata Cloud oder lesen Sie die Dokumentation About Teradata Elastic Compute , um eine kostenkontrollierte, hochskalierbare Dateninfrastruktur aufzubauen.
Häufig gestellte Fragen
Was ist ein Beispiel für elastisches Rechnen?
Was ist ein Beispiel für elastisches Rechnen?
Ein klares Beispiel ist eine Einzelhandels-Datenplattform, die automatisch zusätzliche Rechencluster bereitstellt, wenn das Abfragevolumen während hochversprechender Werbeereignisse stark ansteigt, und diese Cluster dann abschaltet, wenn sich die Nachfrage normalisiert – sodass das Unternehmen nur für aktive Rechenstunden bezahlt.
Was meinst du mit elastischem Rechnen?
Was meinst du mit elastischem Rechnen?
Elastisches Rechnen bezieht sich auf Cloud-Plattformfähigkeiten, die automatisch Rechen-, Speicher- und Speicherressourcen in Echtzeit bereitstellen und entbereiten, abhängig von schwankender operativer Nachfrage.
Was ist der Unterschied zwischen Elastizität und Skalierbarkeit?
Was ist der Unterschied zwischen Elastizität und Skalierbarkeit?
Skalierbarkeit ist die maximale strukturelle Kapazität eines Systems, um langfristiges Wachstum durch das Hinzufügen von Ressourcen über die Zeit zu bewältigen. Elastizität ist die Fähigkeit eines Systems, die Kapazität in Echtzeit automatisch zu erweitern und zu verkleinern, um der schwankenden Nachfrage gerecht zu werden.
Ist elastisches Rechnen dasselbe wie Cloud-Elastizität?
Ist elastisches Rechnen dasselbe wie Cloud-Elastizität?
Ja. In der Enterprise-Cloud-Architektur, im Data Engineering und bei FinOps sind "elastisches Rechnen" und "Cloud-Elastizität" gleichbedeutende Begriffe, die automatisierte Compute-Skalierung beschreiben.